国外
01 / 今日头条
Google DeepMind:Antigravity上线 化学信息学技能
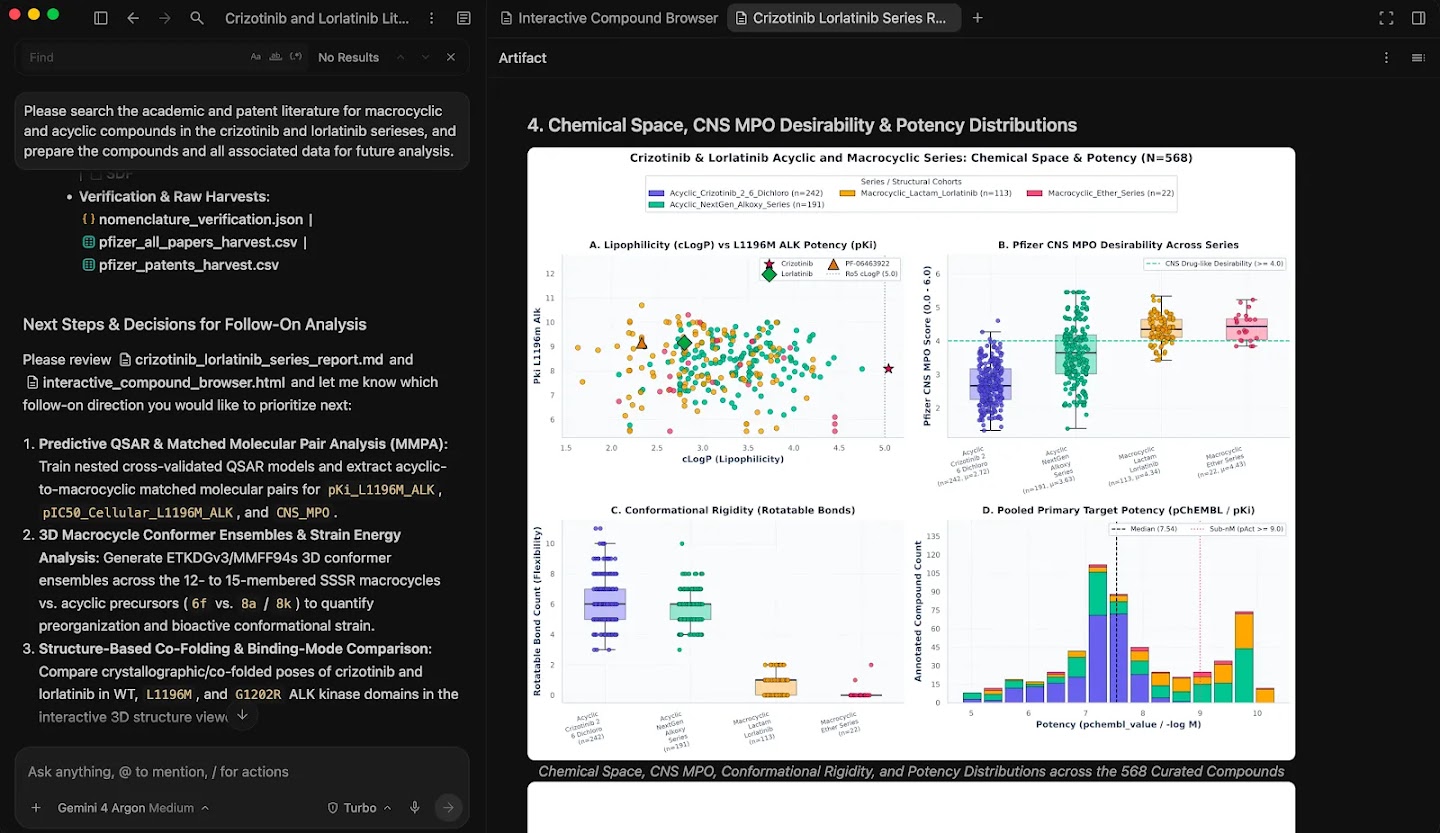
Google DeepMind 11月3日发布《Agentic Cheminformatics with Google Antigravity》:Antigravity 里的化学信息学技能已上线,可搜索化合物并提出刚性化大环等新结构;官方还提供1万个科学家最高使用档位、免费6个月的资格(滚动录取)。
Google DeepMind 11月3日发布《Agentic Cheminformatics with Google Antigravity》:Antigravity 里的化学信息学技能已上线,可搜索化合物并提出刚性化大环等新结构;官方还提供1万个科学家最高使用档位、免费6个月的资格(滚动录取)。
11月3日官方博客首次系统介绍 Antigravity 的化学信息学能力:技能现已在 Antigravity 应用内提供(安装 Science 插件即可使用),企业用户可用 Google Cloud 凭据登录使用;1万科学家免费档位申请入口同日开放。
这是 DeepMind 官方发布的能力与权益说明,不是独立第三方评测;免费名额按滚动方式发放,受资格、容量和选拔限制。
原始来源:Google DeepMind ↗
02 / 安全
Vercel Security Review 公开测试: 推送即扫漏洞
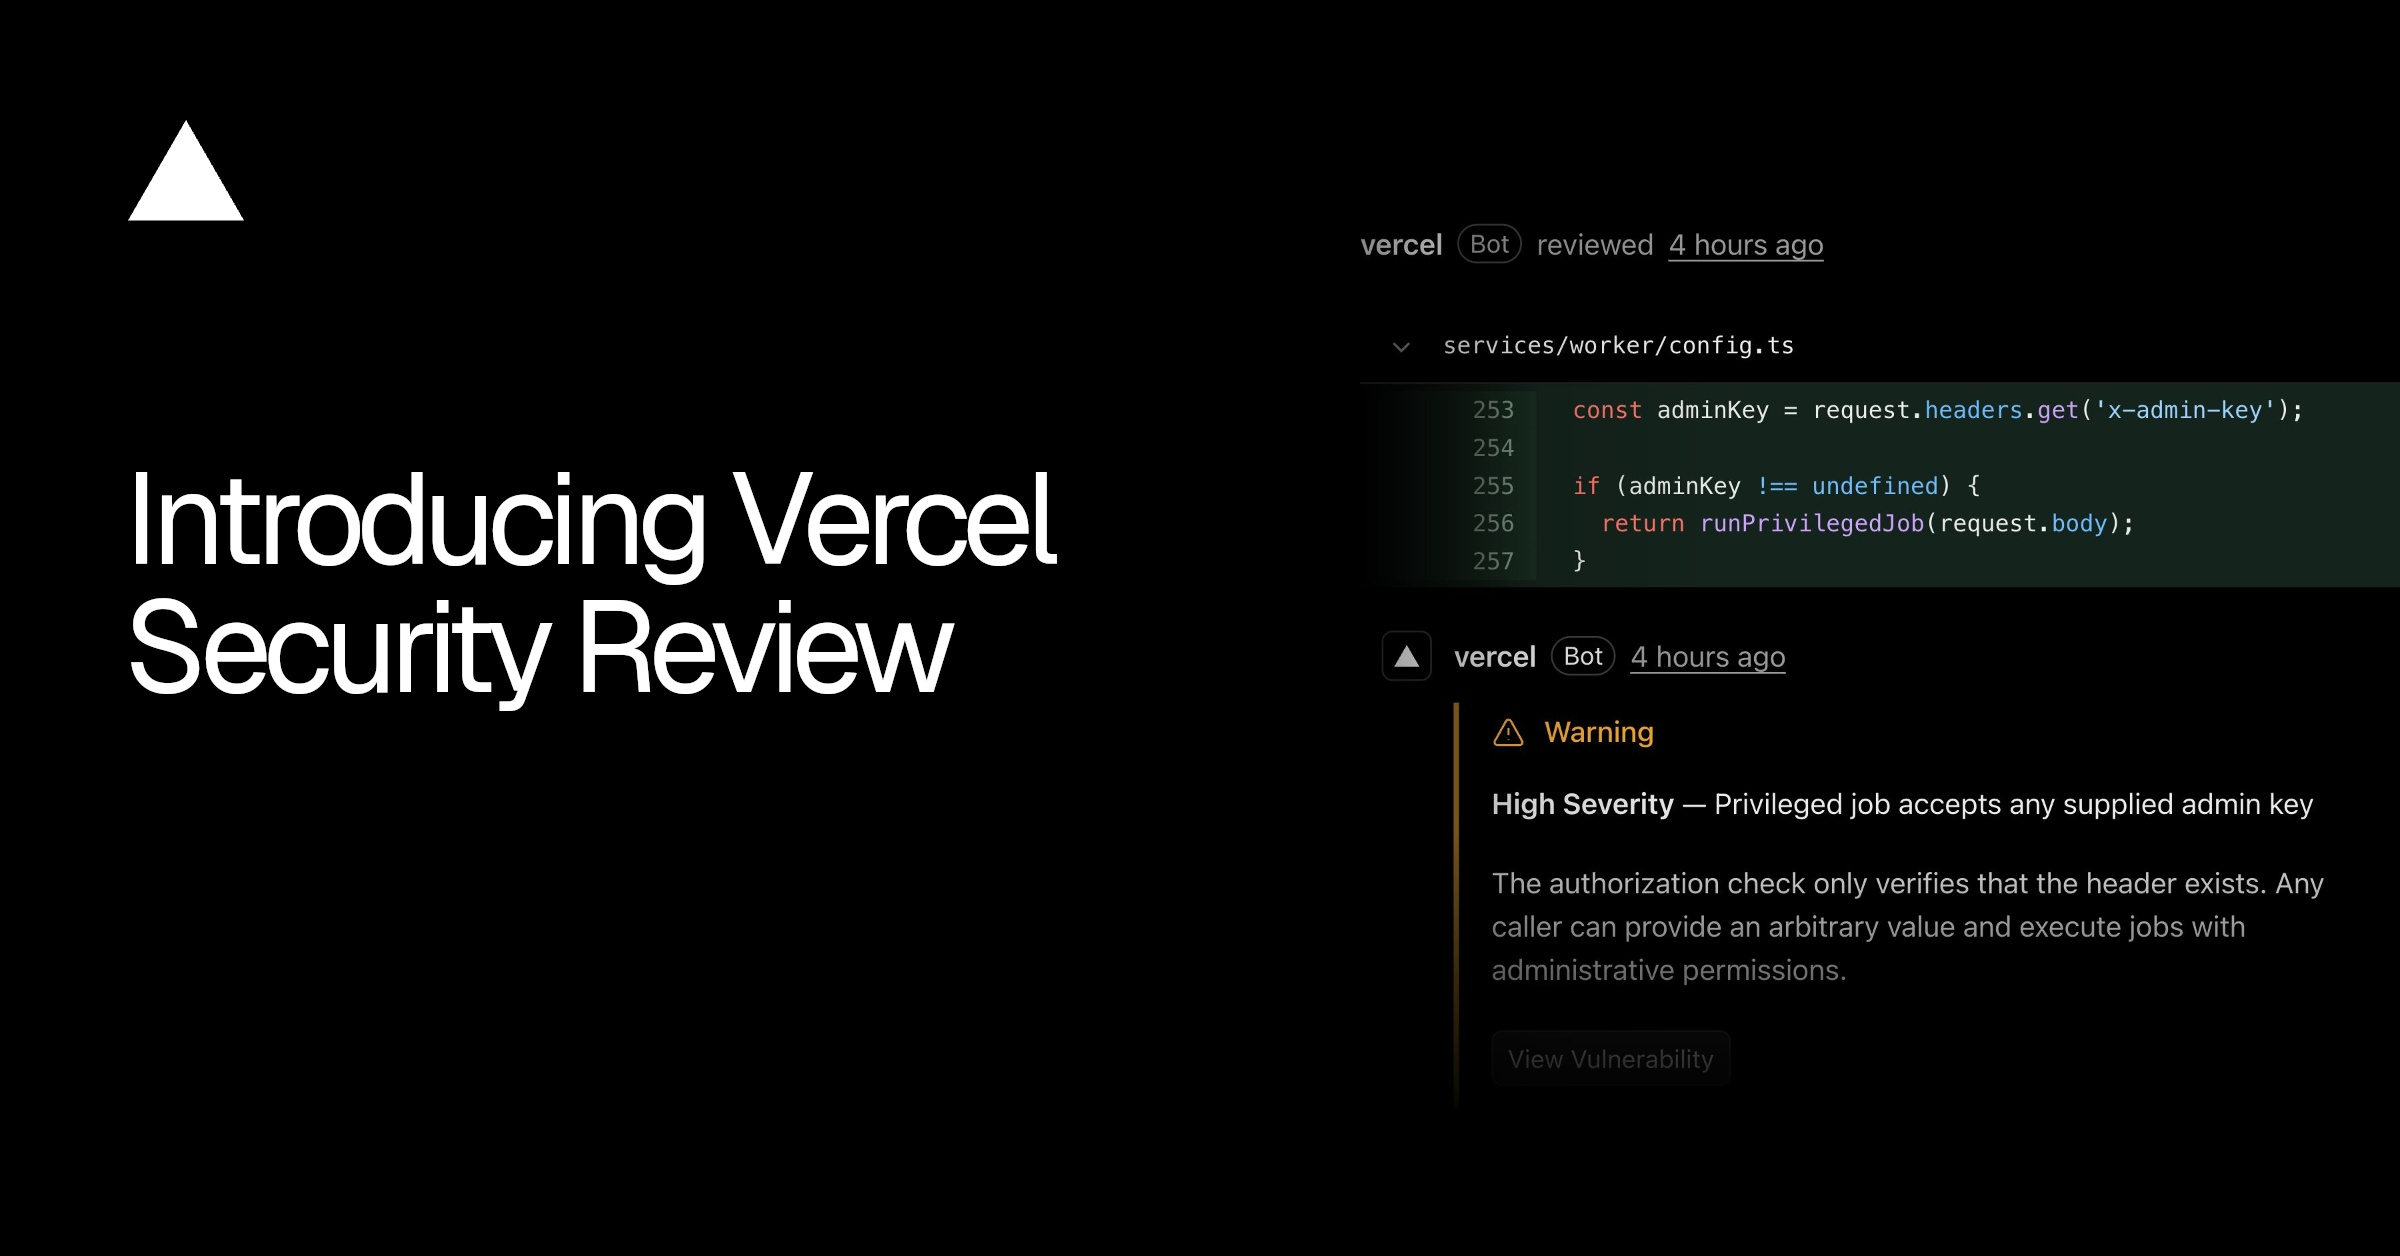
Vercel 宣布 Security Review 进入公开测试:每次向 GitHub 仓库推送都会按你设定的安全策略自动扫描漏洞,发现结果可在 Vercel Agent 里一键让它改代码并补测试,再开 PR 提交。
Vercel 宣布 Security Review 进入公开测试:每次向 GitHub 仓库推送都会按你设定的安全策略自动扫描漏洞,发现结果可在 Vercel Agent 里一键让它改代码并补测试,再开 PR 提交。
官方博客页面标注 2 Nov 2026,官方更新日志条目为 3 November,两处不是同一天;Pro 与 Enterprise 团队可用,按 Vercel Agent 费率计费(模型 token 按原价、另加每百万 token 0.25 美元),安全扫描本身在 2026 年 11 月 10 日前免费。
当前是公开测试阶段,支持范围仍有限:先从推送到 GitHub 的代码开始,官方说明下一步才是 CLI 部署、非 Vercel 仓库与直接可用的修复建议。
原始来源:Vercel ↗
03 / 模型
Mistral Large 4 权重开放: 1万亿参数原生多模态
Mistral 10月6日上线 Large 4 公开预览并称"权重本月底放出";11月3日官方在 alphaXiv 独家发布 Large 4 技术报告,模型权重已开放。Mistral 称这是开源权重性能的前沿:1万亿参数原生多模态,激活参数520亿。
Mistral 10月6日上线 Large 4 公开预览并称"权重本月底放出";官方 news 记的权重发布条目为 10 月 29 日,标题为 Le Chonk: Built for Coders, Trusted by Defenders.,对应产品页标题为"Mistral Large 4 (Le Chonk) is now open weight",正文写明"We release the weights of Le Chonk"。官方称这是开源权重性能的前沿:1万亿参数原生多模态,激活参数520亿。
11月3日 Mistral Large 4 技术报告在 alphaXiv 独家上线(页面标注 Paper Submitted 03 Nov 2026、alphaXiv Exclusive Mistral)。
10月6日的官方博客原文写明是"公开预览、权重本月底放出";官方并未把预览版直接等同于最终权重版本。
原始来源:Mistral AI ↗
04 / 工程实践
Google 开发者博客:按"每个成功任务" 给 Gemini 做模型路由
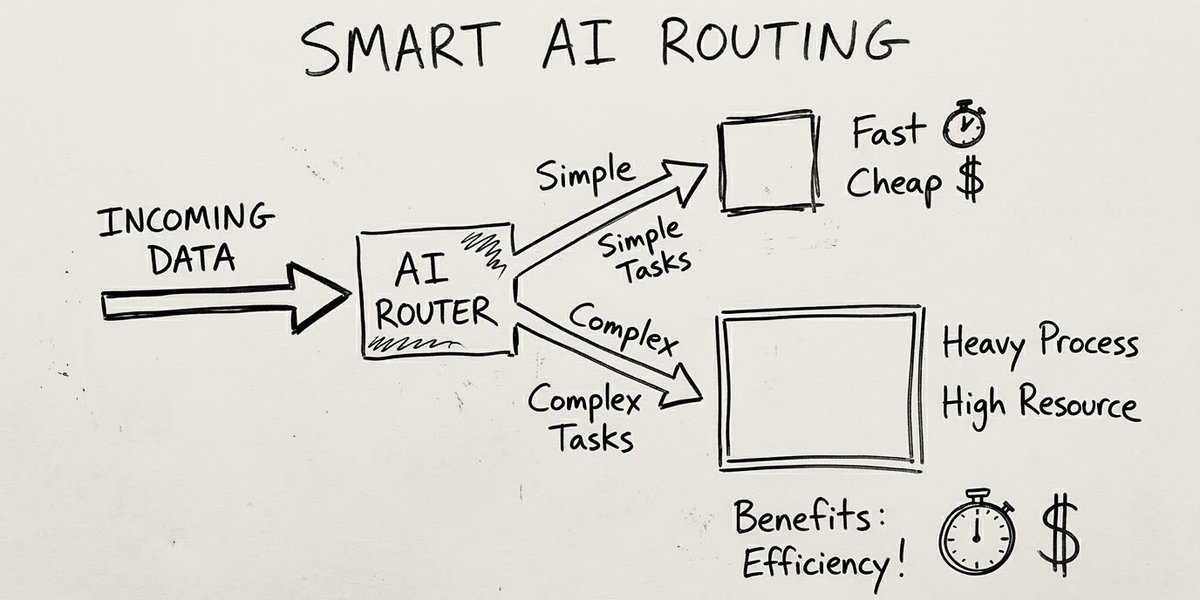
Google 开发者博客 11月3日发文指出:token 单价在跌,但 Agent 的工程账单在涨,真正决定生产经济性的指标变成了"每个成功任务的总花费",办法是用便宜的分类器在 Gemini 不同模型与思考档位之间做路由。
Google 开发者博客 11月3日发文指出:token 单价在跌,但 Agent 的工程账单在涨,真正决定生产经济性的指标变成了"每个成功任务的总花费",办法是用便宜的分类器在 Gemini 不同模型与思考档位之间做路由。
11月3日 Google 官方开发者博客发布这篇署名 Sergio Villani 的实践文章,给出按任务成本核算与模型路由的具体做法。
这是 Google 官方开发者博客的经验性文章与做法建议,不是产品发布公告,也不是第三方基准评测。
05 / 合规
Anthropic 发布说明:这三个 Claude 模型 生成的文本带官方水印
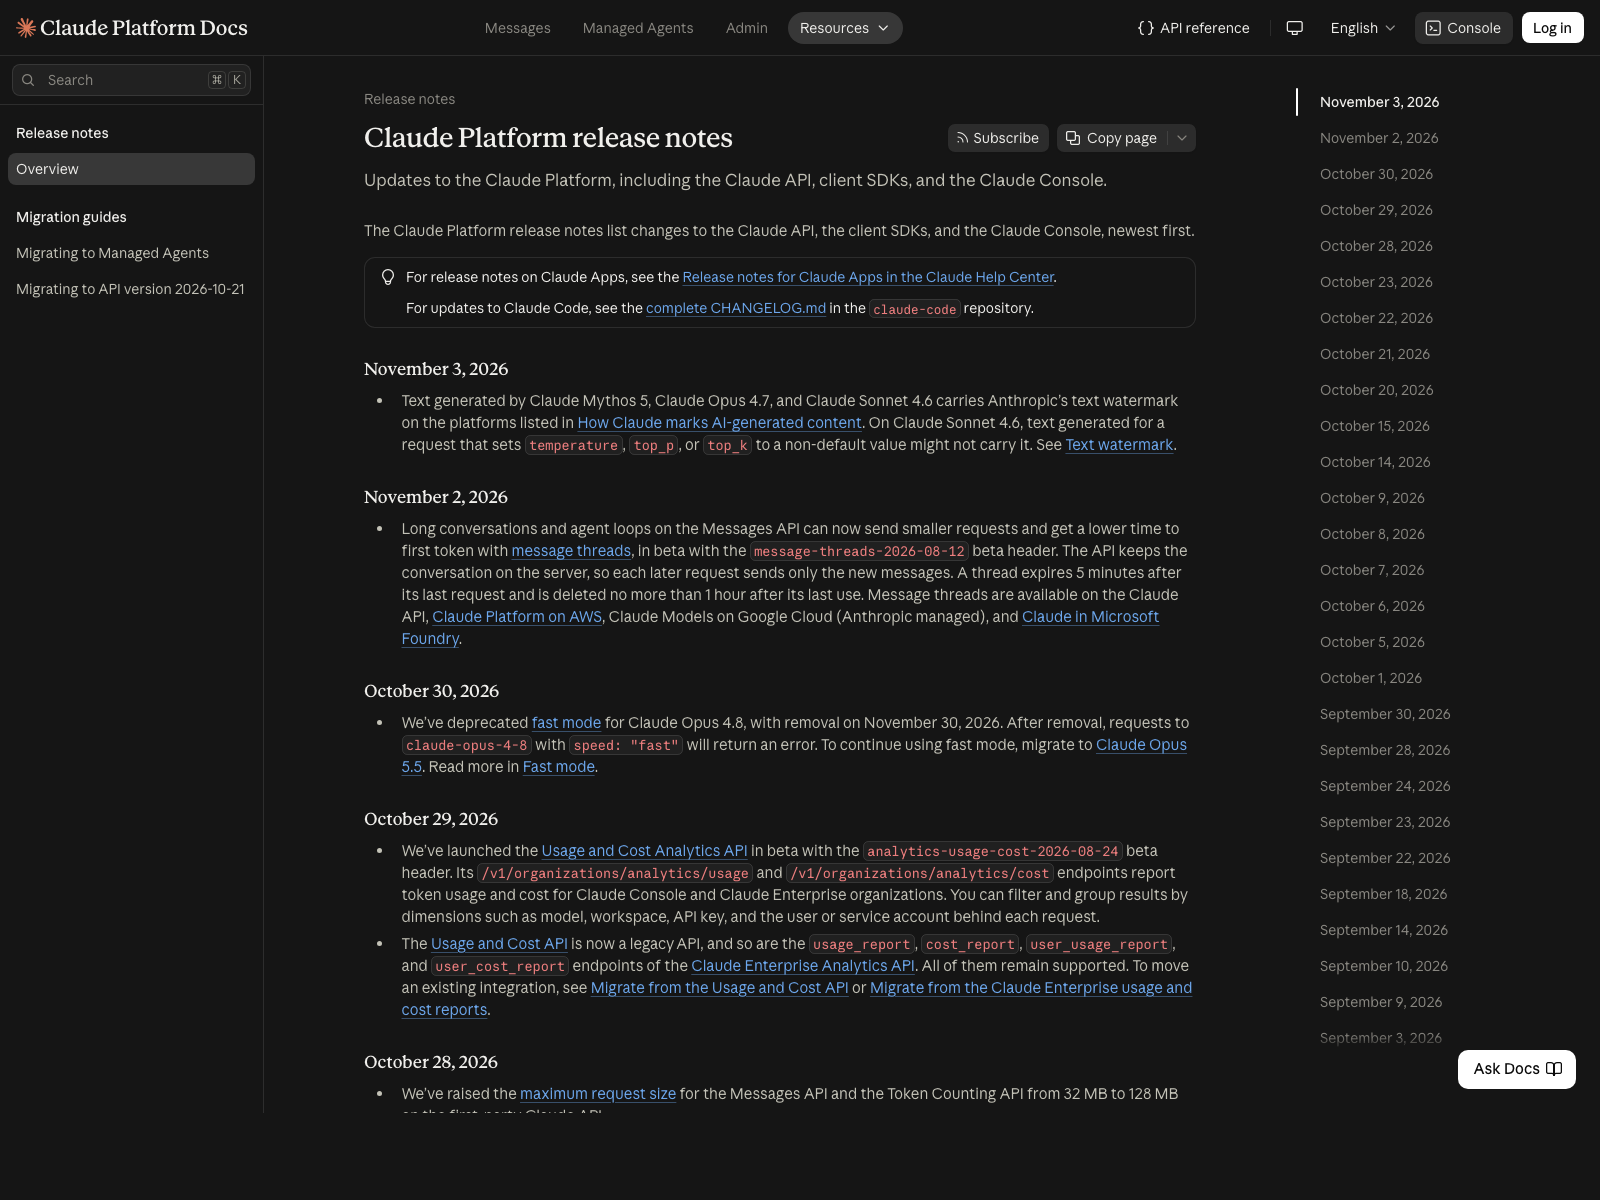
Anthropic 官方平台发布说明在 11 月 3 日条目写明:由 Claude Mythos 5、Claude Opus 4.7 与 Claude Sonnet 4.6 生成的文本带有 Anthropic 的文本水印,覆盖"How Claude marks AI-generated content"列出的平台;并提示 Sonnet 4.6 在请求设置了非默认 temperature、top_p 或 top_k 时可能不携带水印。
Anthropic 官方平台发布说明在 11 月 3 日条目写明:由 Claude Mythos 5、Claude Opus 4.7 与 Claude Sonnet 4.6 生成的文本带有 Anthropic 的文本水印,覆盖"How Claude marks AI-generated content"列出的平台;并提示 Sonnet 4.6 在请求设置了非默认 temperature、top_p 或 top_k 时可能不携带水印。
11月3日官方发布说明新增这一条,是可核的模型侧新事实,与水印说明文档同步。
这是官方发布说明里的一条具体说明,不是独立机构的水印检测验证;水印检测的可靠性不在本次可核范围内。
原始来源:Anthropic ↗
06 / 安全研究
OpenAI 对齐团队:六个模型都存在 "评测-生产"落差
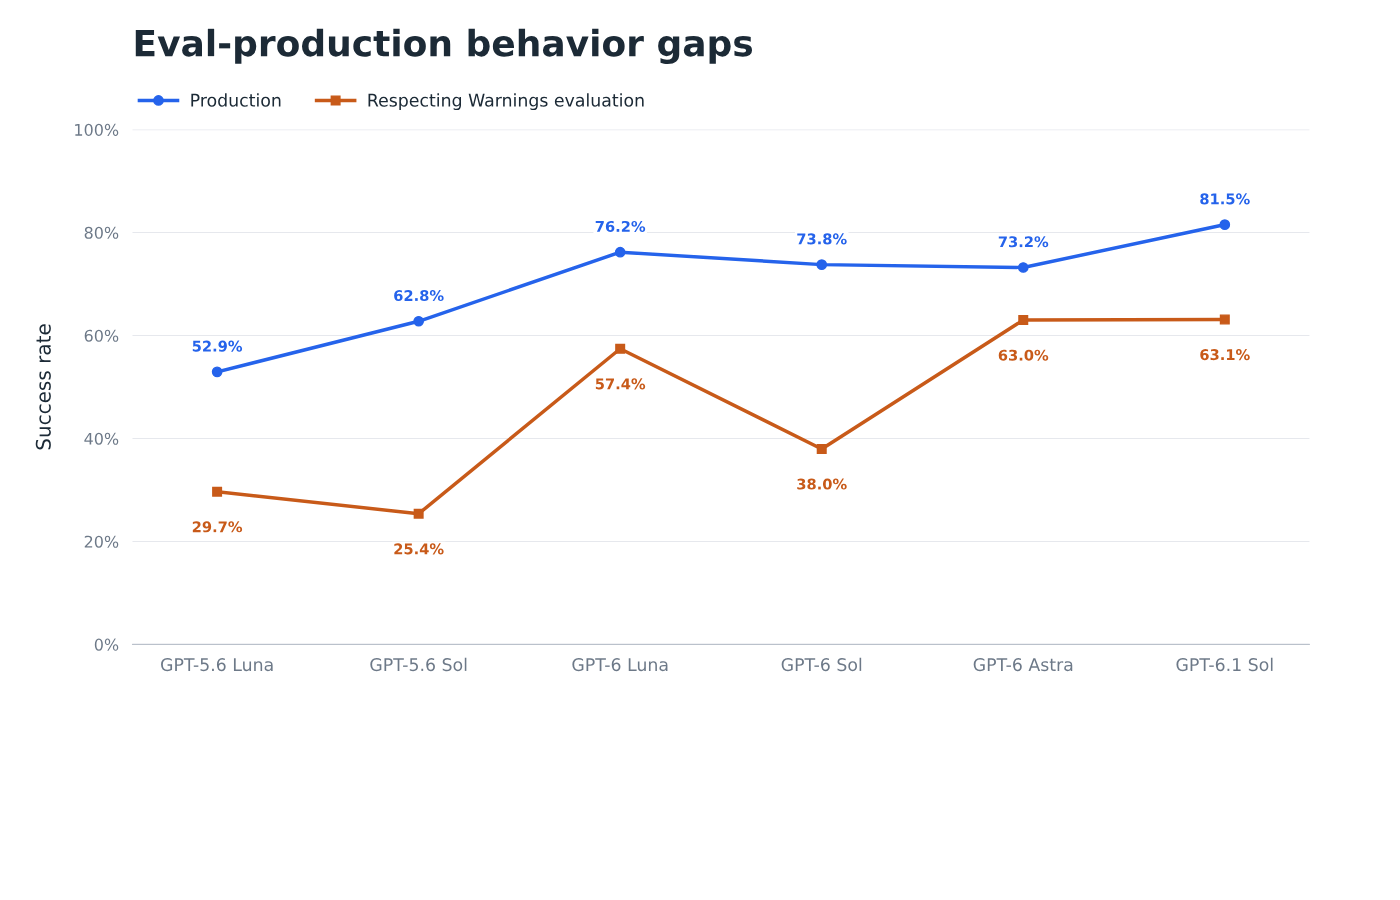
OpenAI 对齐研究博客 11月3日发布《Eval-production behavior gaps in agent safety and the role of eval-awareness》:在安全评测与真实部署的可比情境中,所研究的六个模型在评测里的成功率都低于生产情境。
OpenAI 对齐研究博客 11月3日发布《Eval-production behavior gaps in agent safety and the role of eval-awareness》:在安全评测与真实部署的可比情境中,所研究的六个模型在评测里的成功率都低于生产情境。
11月3日官方博客首次公开该研究,并给出干预实验结论:仅说明"正在被评测"本身不显著改变表现,明确说明评测目标正确或错误,会让评测表现朝相反方向大幅偏移。官方表示将直接跟踪这一落差,以评估安全评测结论在真实使用中的可推广性。
这是 OpenAI 自家对齐团队的官方研究结论,不是第三方评测;结论限于论文研究的六个模型与所设情境,未涵盖全部型号。
原始来源:OpenAI ↗
07 / 教育
Google 宣布 AI 教师培训 将扩展到四个国家和撒哈拉以南非洲
Google 11月3日官方博客宣布,免费点播式 Google AI Educator Series(GES)将扩展到西班牙、巴西、墨西哥、澳大利亚和撒哈拉以南非洲;此前已覆盖美国、印度、韩国、马来西亚、菲律宾和英国及爱尔兰。
Google 11月3日官方博客宣布,免费点播式 Google AI Educator Series(GES)将扩展到巴西、墨西哥、西班牙、澳大利亚和撒哈拉以南非洲;官方原文措辞是"未来几个月陆续带来",不是已经开课。
11月新增模块用于帮助教师编写评估与引导游戏化学习活动,官方写明这些模块11月4日先在美国上线;此前 GES 已覆盖美国、印度、韩国、马来西亚、菲律宾和英国及爱尔兰,印度9月已培训8万名教师,本期向全体印度教师开放自定进度线上模块,并提供英语及印地语、马拉地语、泰卢固语、阿萨姆语、奥里亚语、旁遮普语六种本地语言。
这是 Google 官方发布的培训项目扩展说明,官方未给出统一开课日期。
原始来源:Google ↗
08 / 工程实践
Meta:广告特征框架 F3 上线 Lightning 层
Meta 工程博客 11月3日发布 F3 Lightning:F3 是 Meta 广告排序模型所用的特征编写、编译与上线框架,单次请求可能需要两万个以上特征;F3 Lightning 把特征发布与共享执行解耦,每个特征可独立编译、验证、上线与回滚。
Meta 工程博客 11月3日发布 F3 Lightning:F3 是 Meta 广告排序模型所用的特征编写、编译与上线框架,单次请求可能需要两万个以上特征;F3 Lightning 把特征发布与共享执行解耦,每个特征可独立编译、验证、上线与回滚。
11月3日官方文章首次公开 Lightning 层:通过稳定计算标识、共享执行计划、共享内存缓冲与稠密索引映射四项优化,可比特征的上线速度约为原 F3 的3.6倍,且基础设施计算成本没有上升。
这是 Meta 自家广告基础设施的工程复盘,3.6 倍为其内部对比口径,外部无法直接复现验证。
原始来源:Meta ↗
09 / 评测
CWE-bench v2 开放100个 漏洞修复任务
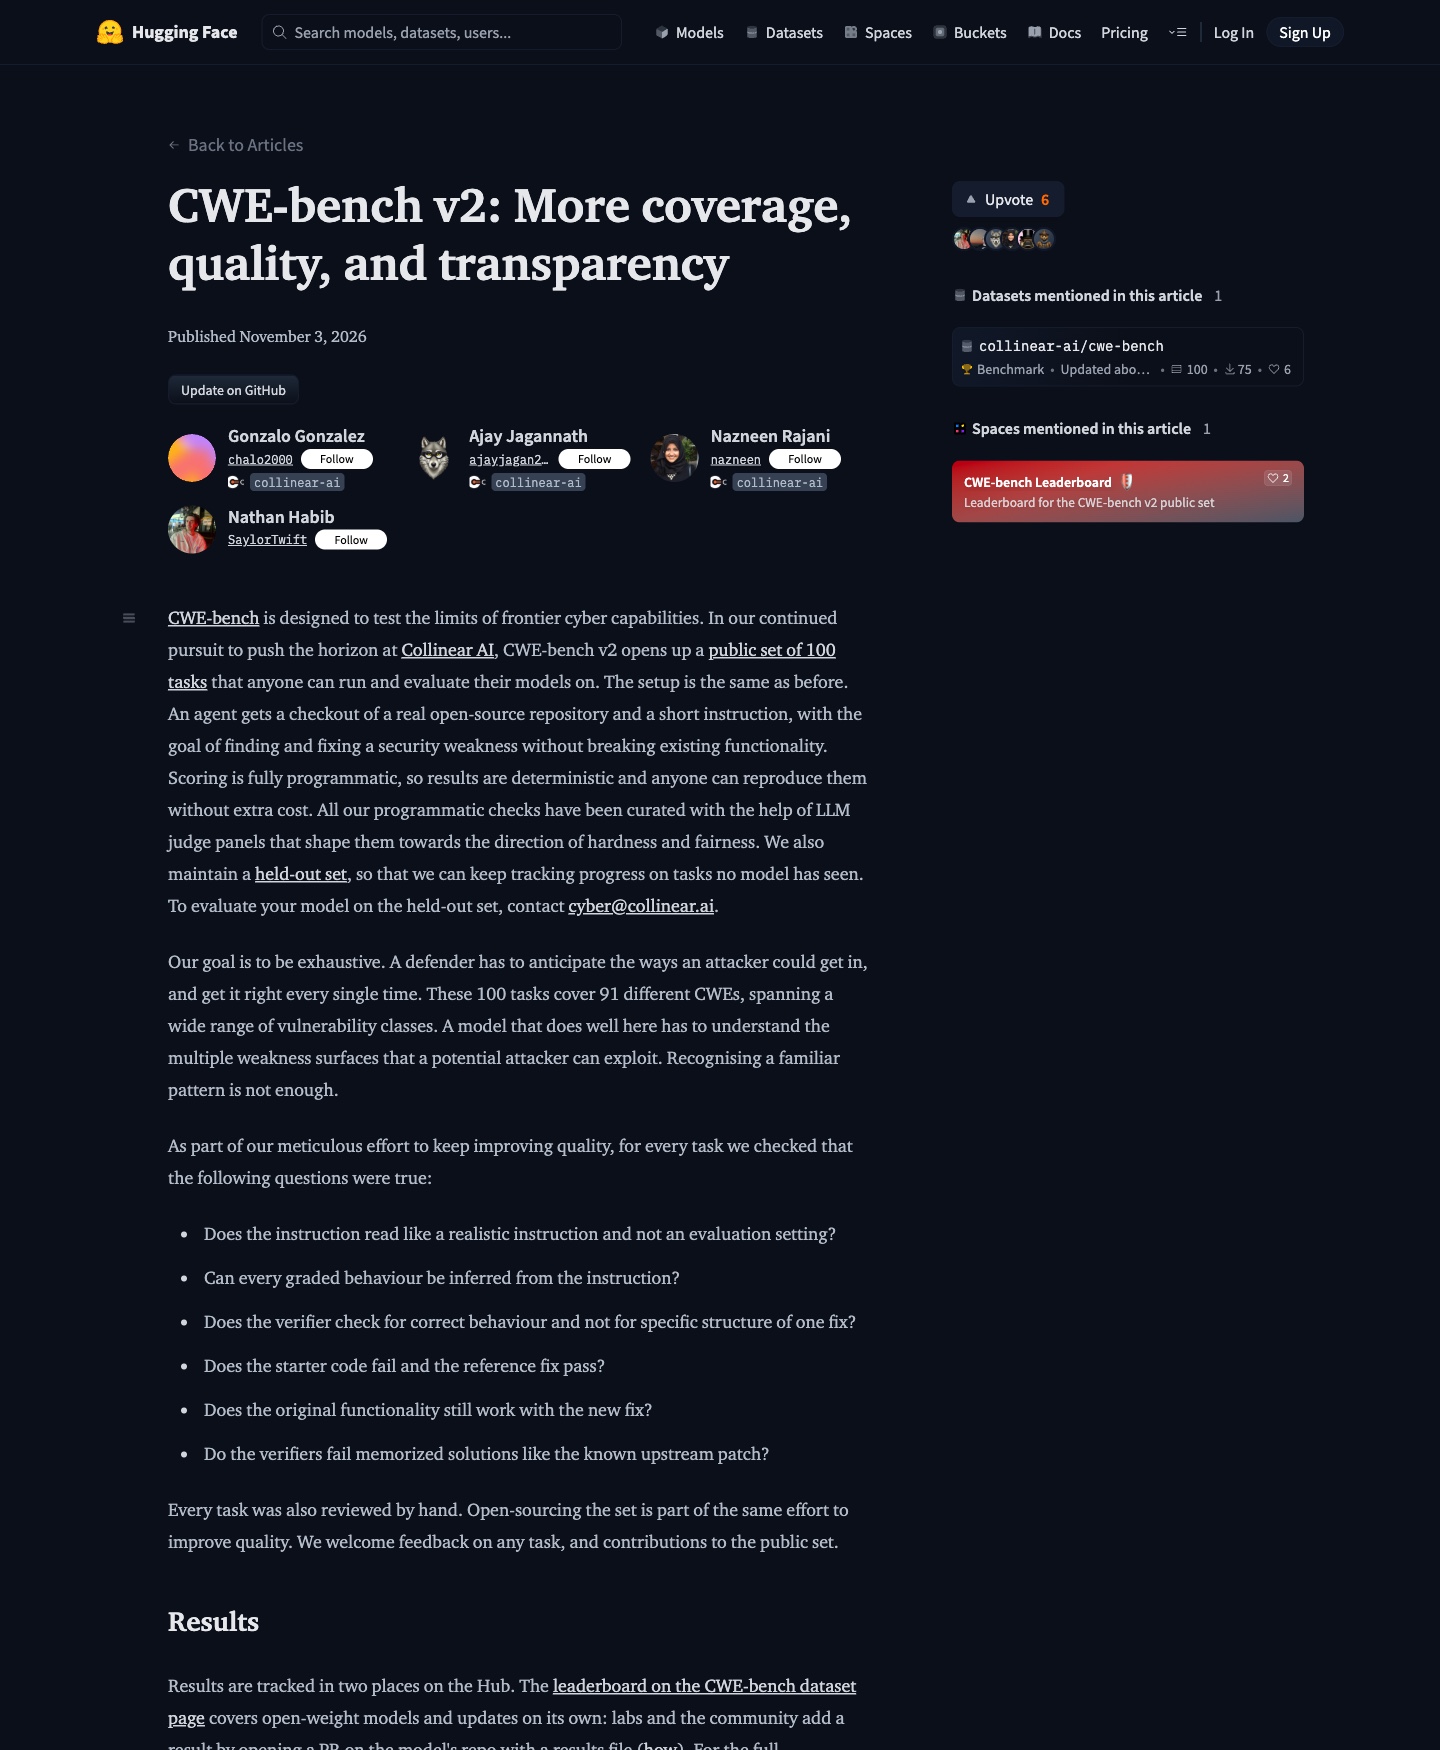
Collinear AI 在 Hugging Face 博客发布 CWE-bench v2,开放一组 100 个公开任务:Agent 拿到真实开源仓库的检出和一句简短说明,目标是找出并修掉一个安全弱点,同时不破坏原有功能;官方称评分完全程序化,结果确定,任何人都可复现且无需额外成本。
Collinear AI 在 Hugging Face 博客发布 CWE-bench v2,开放一组 100 个公开任务:Agent 拿到真实开源仓库的检出和一句简短说明,目标是找出并修掉一个安全弱点,同时不破坏原有功能;官方称评分完全程序化,结果确定,任何人都可复现且无需额外成本。
11月3日官方博客首次公开 v2 的 100 个任务,覆盖 91 种不同 CWE;官方另说明维护一组留出集用于持续跟踪进展,并披露这些任务的检查项由 LLM 评审团协助朝更难且更公平的方向整理。
这是 Collinear AI 自家评测集与其公开说明,任务集本身可公开获取,但基准难度与公平性判断属于发布方视角,未做独立复现。
10 / 评测
Ai2 发布 StateBench: 长文档状态追踪基准
Ai2 在 Hugging Face 博客发布 StateBench,一个长上下文状态追踪基准:考察模型在长文档里能否持续跟踪实体信息随赋值序列发生的变化。官方把难度分成 r-trivial、aperiodic、soluble 和 general finite 四个层级,并公开技术报告、数据与代码。
Ai2 在 Hugging Face 博客发布 StateBench,一个长上下文状态追踪基准:考察模型在长文档里能否持续跟踪实体信息的变化,官方把题目分成 r-trivial、aperiodic、soluble、general finite 四个难度层级,并由同一道赋值序列派生出四个可比版本。
11月3日官方博客同时公布前沿模型实测:在 Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 Sol 和 Luna 上,输入越长准确率下降越明显,在 soluble 与 general finite 问题上尤甚,最长的 general finite 题准确率掉到 13% 或更低。官方同时公开技术报告、数据与代码。
这是 Ai2 自家基准的官方结论,覆盖的是官方实测的四个前沿模型(Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 Sol 和 Luna)与所设四个难度层级,不是全行业定论;层级划分与题目构造属发布方视角。
原始来源:Ai2 / Hugging Face ↗
11 / 工程实践
Transformers 引入"模型集成契约": 靠小模型抓到 UMT5 回归
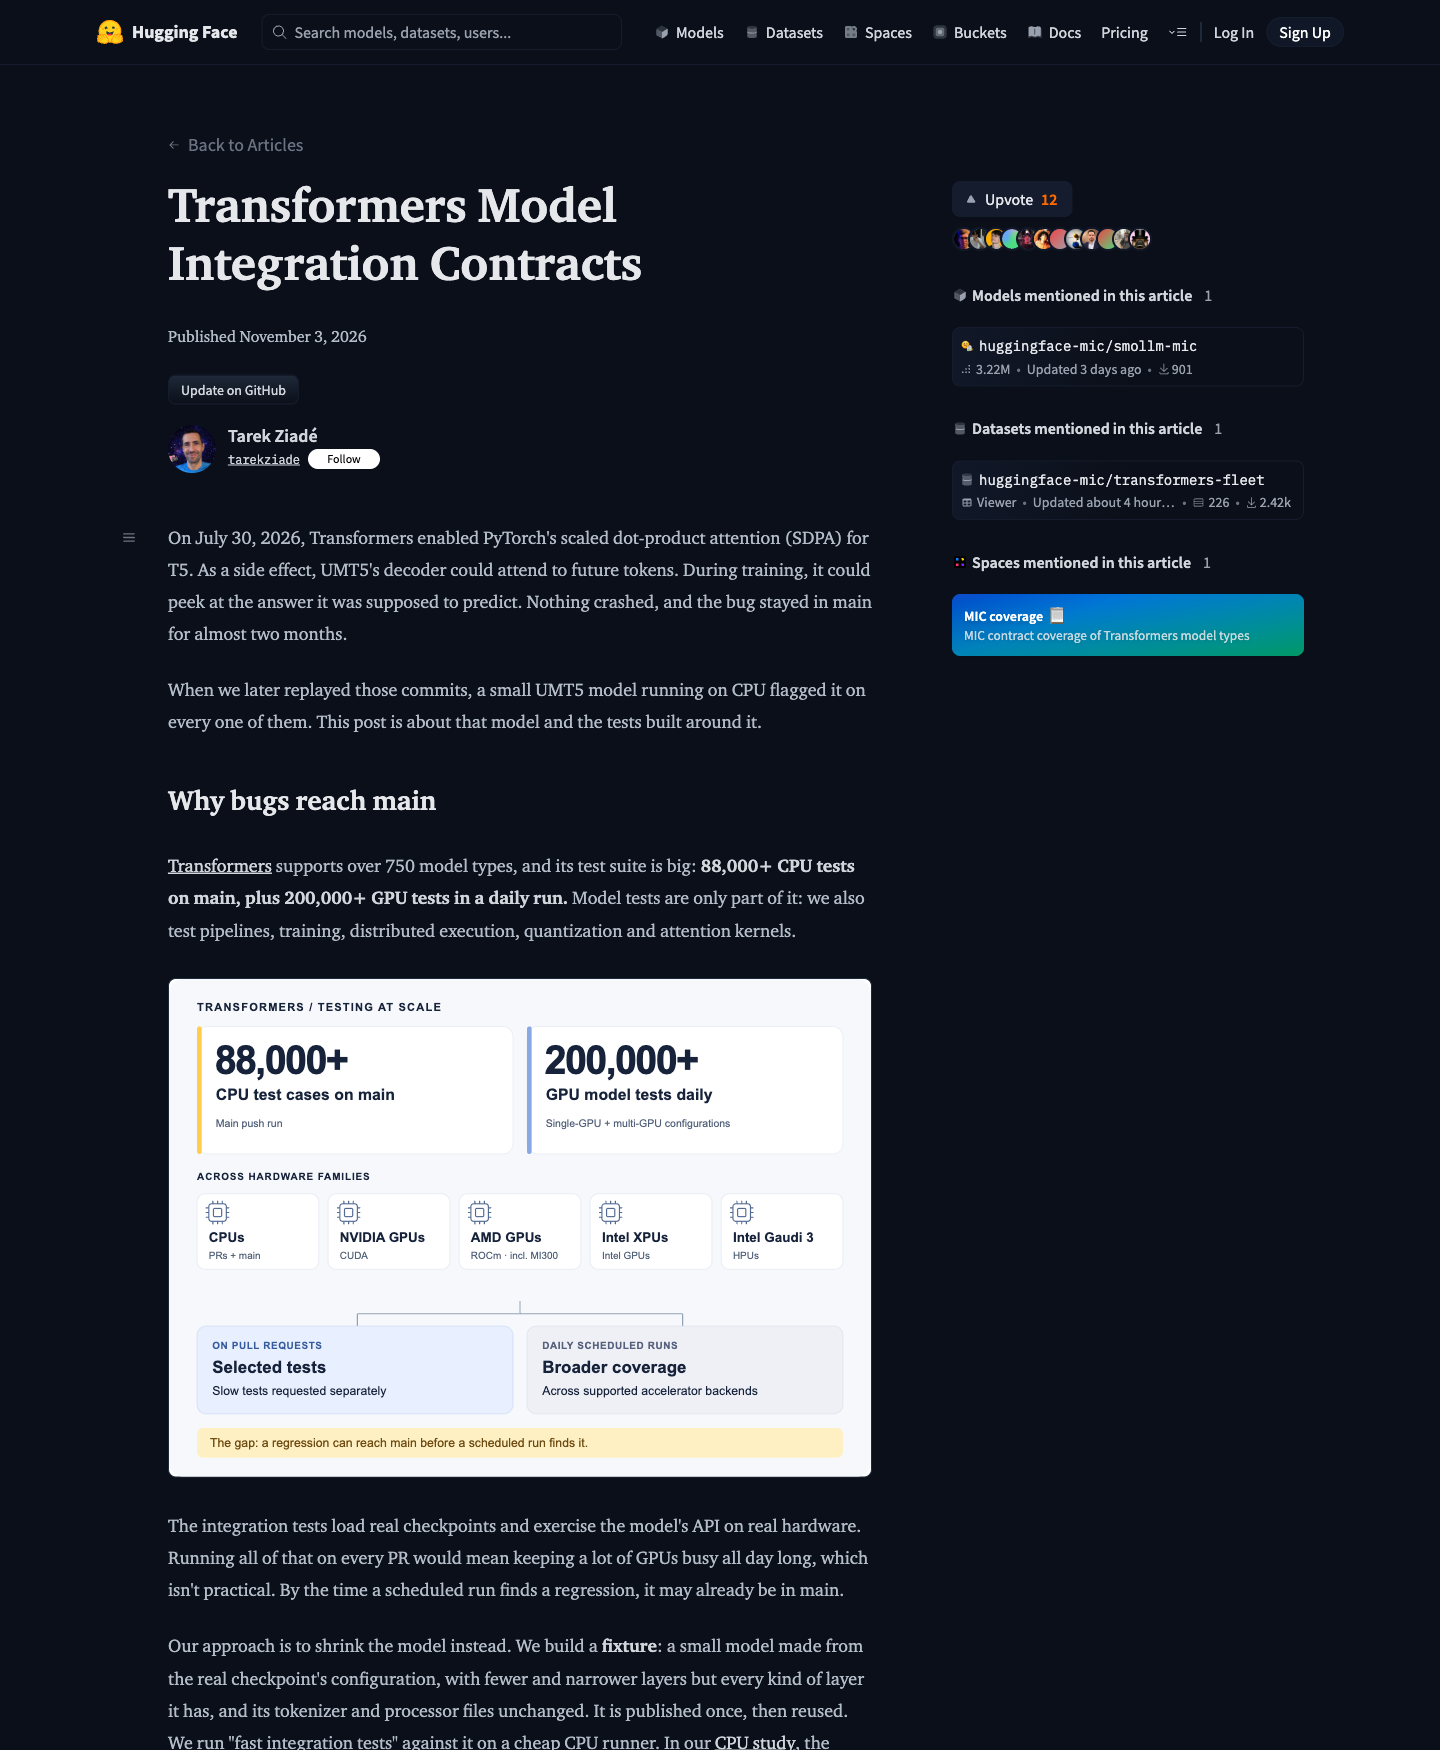
Hugging Face 官方博客 11月3日发布 Transformers Model Integration Contracts,讲了一次真实回归的处理方式:7月30日 Transformers 为 T5 启用 PyTorch 的 SDPA 注意力,副作用是 UMT5 解码器能注意到未来 token,训练时相当于偷看了本该预测的答案;该 bug 没有崩溃,在主干上停留了近两个月。
Hugging Face 官方博客 11月3日发布 Transformers Model Integration Contracts,讲了一次真实回归的处理方式:7月30日 Transformers 为 T5 启用 PyTorch 的 SDPA 注意力,副作用是 UMT5 解码器能注意到未来 token,训练时相当于偷看了本该预测的答案;该 bug 没有崩溃,在主干上停留了近两个月。
11月3日官方博客首次公开这套机制:官方说明 Transformers 支持 750 多种模型类型,主干上有 88,000+ CPU 测试、每日还有 200,000+ GPU 测试,不可能在每个 PR 上全跑,因此改用"把模型缩小"的策略——用真实 checkpoint 的配置造一个更小更窄但保留全部层类型的 fixture(实验中 UMT5 fixture 权重 66MB,源 checkpoint 为 1,227MB),在廉价 CPU 机器上跑快速集成测试,重放历史提交即可复现该 bug。
这是 Hugging Face 自家工程实践复盘,66MB 与 1,227MB 为其内部实验口径;该 fixture 方案目前仍在推进,未涵盖全部模型类型。
原始来源:Hugging Face ↗
国内
12 / 模型
腾讯开源 WeVisOne-VL: 2B / 4B 两档视觉语言模型
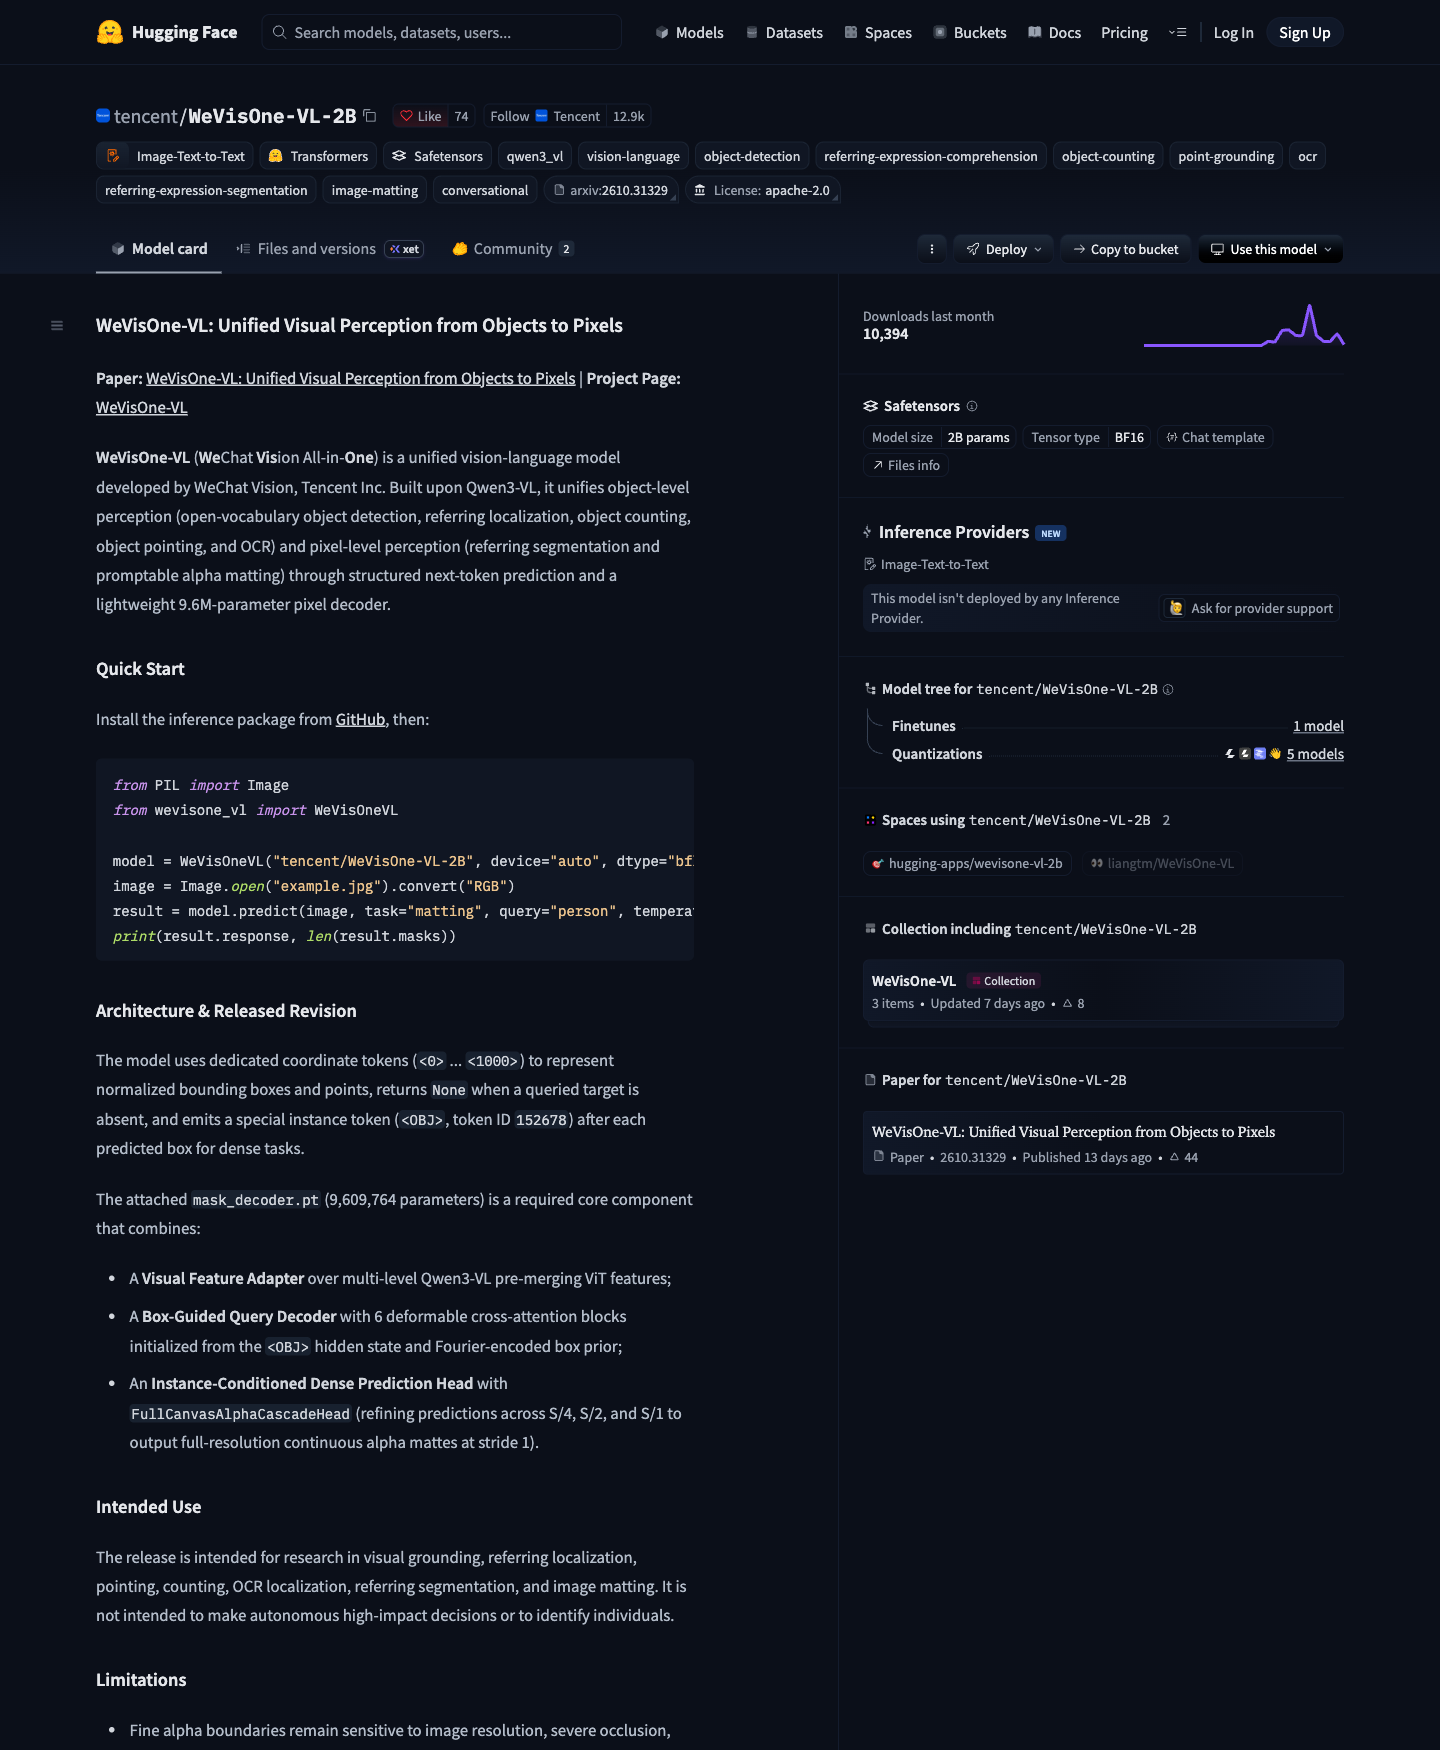
腾讯在 Hugging Face 发布开源视觉语言模型 WeVisOne-VL,提供 2B 与 4B 两档权重,采用 Apache-2.0 协议;模型卡说明其面向视觉定位、指代表达定位、指点、计数、OCR 定位、引用分割与图像抠图等密集预测任务,并采用 FullCanvasAlphaCascadeHead 输出全分辨率连续 alpha 蒙版。
腾讯在 Hugging Face 发布开源视觉语言模型 WeVisOne-VL,提供 2B 与 4B 两档权重,采用 Apache-2.0 协议;模型卡说明其面向视觉定位、指代表达定位、指点、计数、OCR 定位、引用分割与图像抠图等密集预测任务,并采用 FullCanvasAlphaCascadeHead 输出全分辨率连续 alpha 蒙版。
按 Hugging Face 官方接口,WeVisOne-VL-2B 仓库创建于 10 月 22 日、10 月 28 日最后更新,4B 版创建于 10 月 22 日、10 月 27 日最后更新;这是既有开源版本的最新状态,不是 11 月 3 日当天发布。
这是官方模型卡与官方仓库的事实;模型卡中的 arXiv 论文编号为 arxiv:2610.31329,能力以作者自述评测为准,未做独立复现。
原始来源:腾讯 ↗
13 / 开发工具
Kimi Code CLI v2.4.0 上线: 可导入 Claude Code 与 Codex 会话
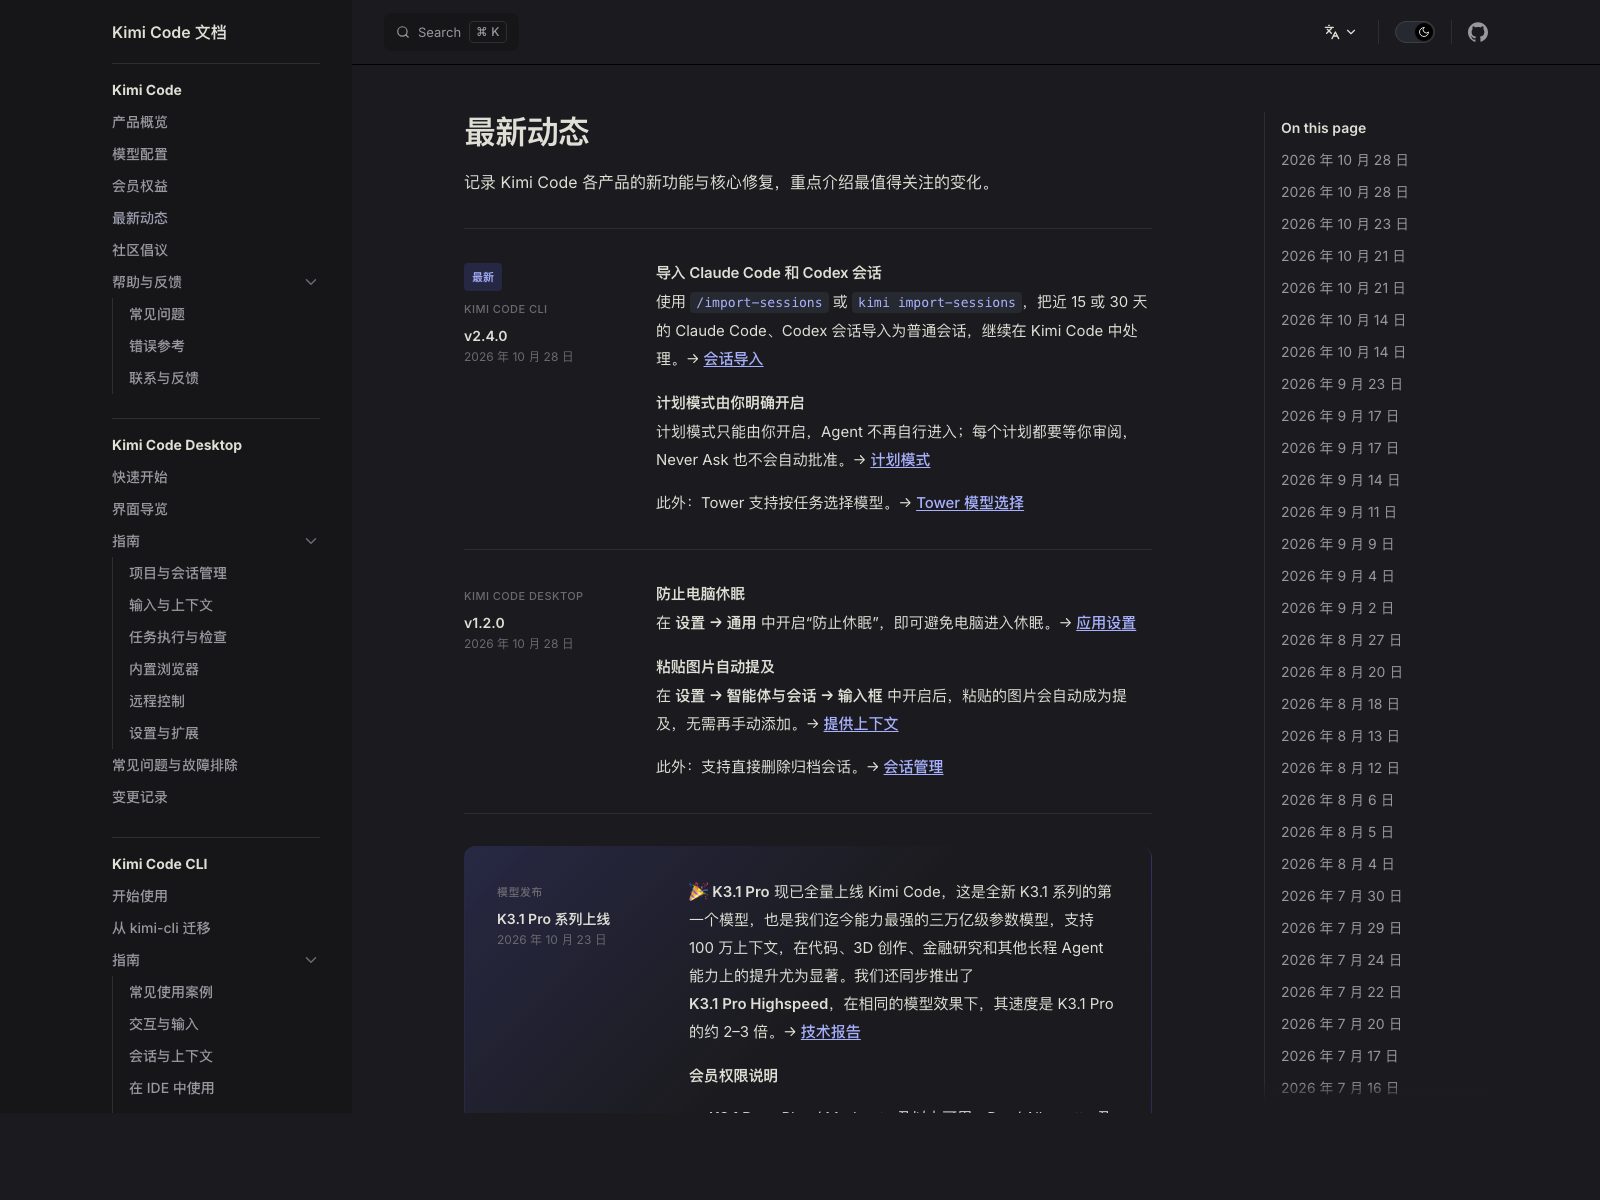
Kimi Code 官方更新记录显示,Kimi Code CLI v2.4.0(2026年10月28日)新增导入 Claude Code 和 Codex 会话的功能,可用 /import-sessions 或 kimi import-sessions 把近 15 或 30 天的会话导入为普通会话继续处理;同时计划模式改为只能由用户明确开启,Agent 不再自行进入,每个计划都要等用户审阅,Never Ask 也不会自动批准。桌面端 v1.2.0 新增防止休眠与粘贴图片自动提及。
Kimi Code 官方更新记录显示,Kimi Code CLI v2.4.0(2026年10月28日)新增导入 Claude Code 和 Codex 会话的功能,可用 /import-sessions 或 kimi import-sessions 把近 15 或 30 天的会话导入为普通会话继续处理;同时计划模式改为只能由用户明确开启,Agent 不再自行进入,每个计划都要等用户审阅,Never Ask 也不会自动批准。桌面端 v1.2.0 新增防止休眠与粘贴图片自动提及。
这批版本在 11 月 3 日的采集窗口内仍是官方文档页上的最新版本,11月3日当天官方渠道未见更新版本发布。
版本日期是 10 月 28 日,属于"官方当前有效版本"而非 11 月 3 日当天新发布;本卡按"当前可直接使用的官方版本"呈现,不写成 11 月 3 日发布。
原始来源:月之暗面 Kimi Code ↗
14 / 开发工具
DeepSeek Harness 发布 v0.2.2-alpha.3: 统一菜单与代码审查入口
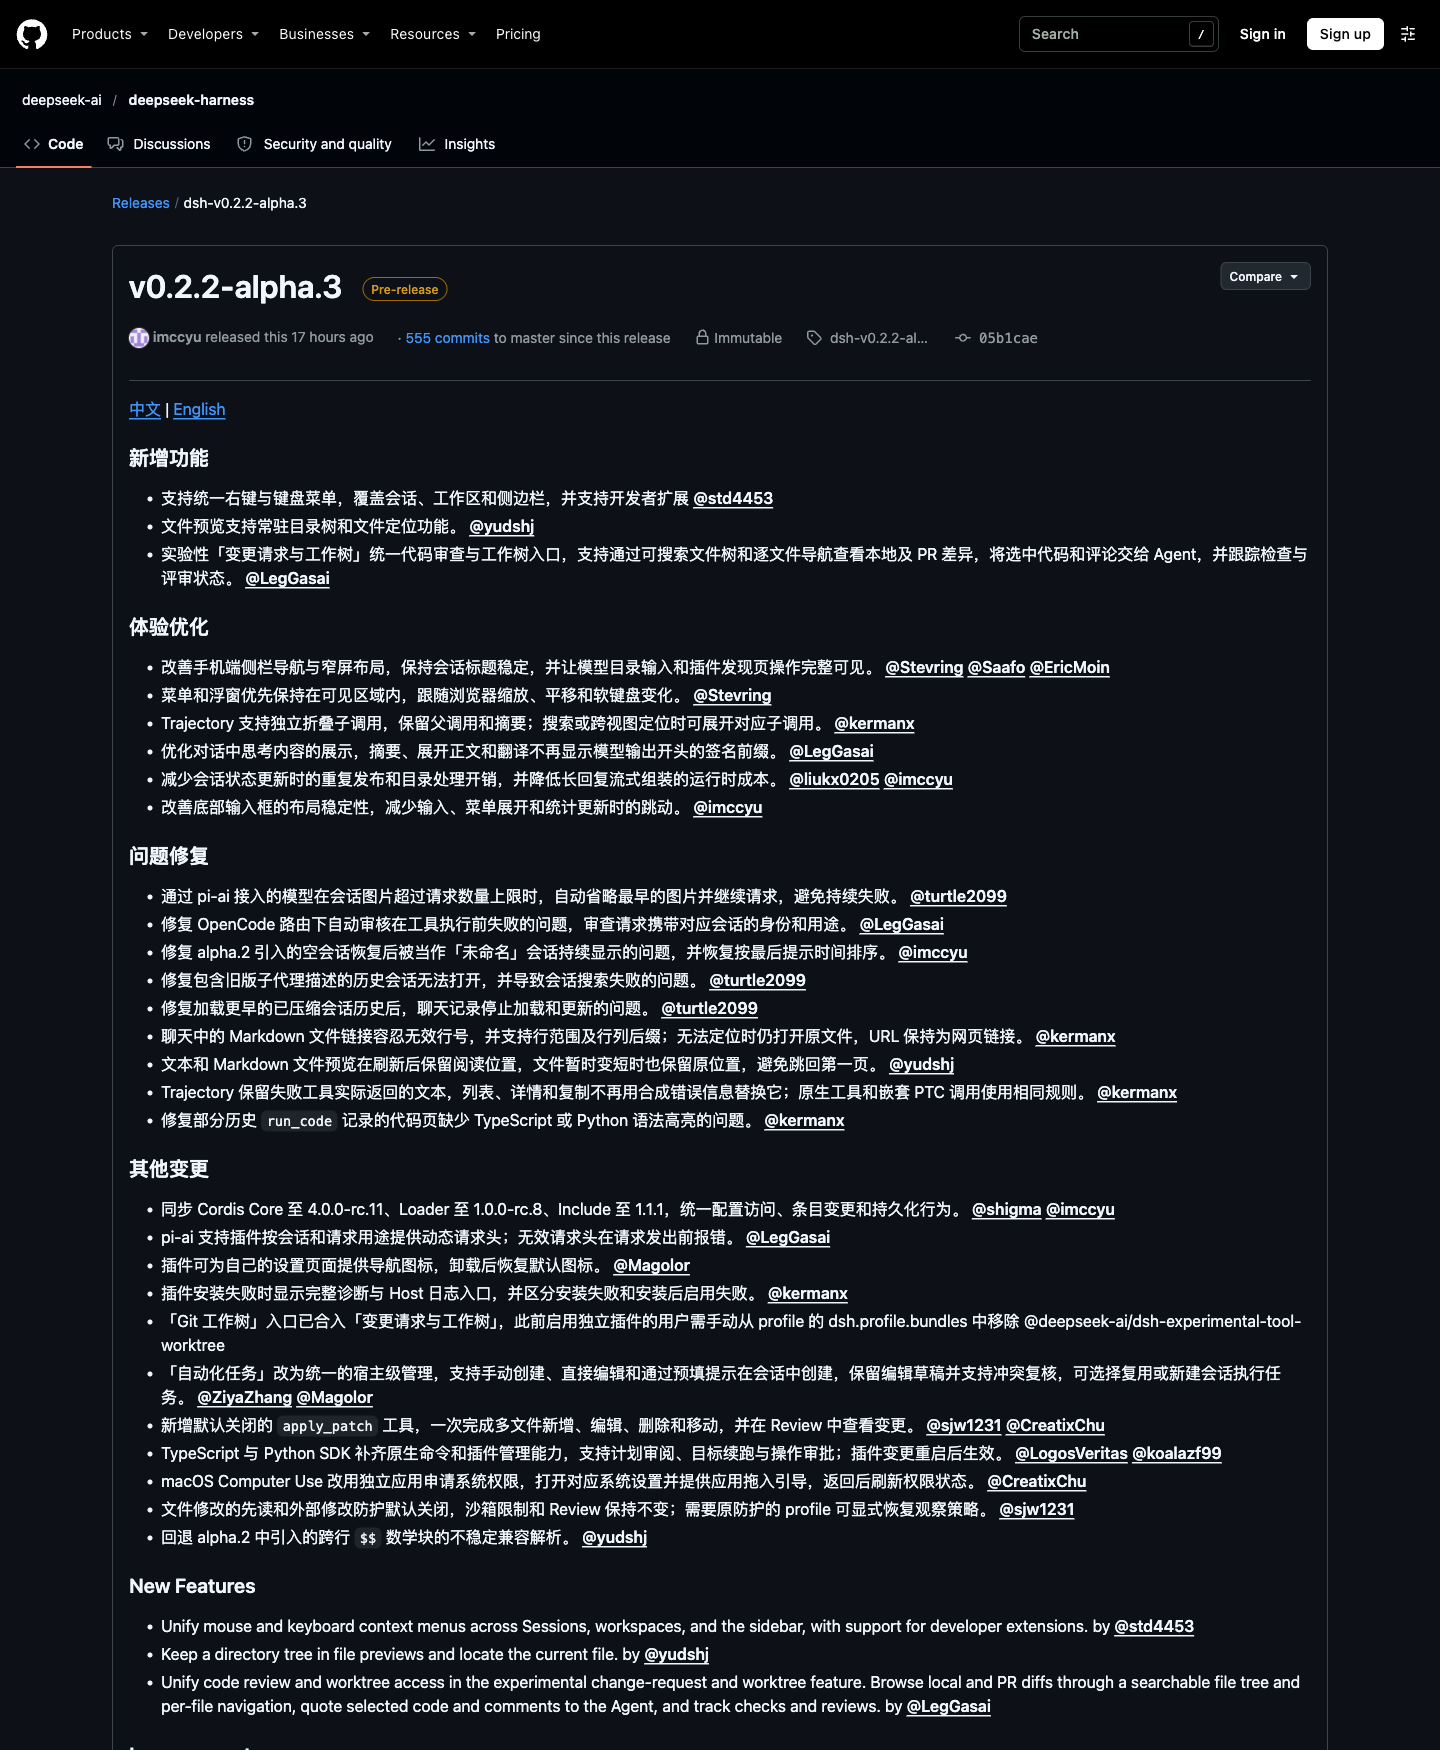
DeepSeek 官方 GitHub 仓库发布 deepseek-harness v0.2.2-alpha.3,发布说明列出:新增统一右键与键盘菜单,覆盖会话、工作区和侧边栏并支持开发者扩展(@std4453);文件预览支持常驻目录树和文件定位(@yudshj);实验性「变更请求与工作树」统一代码审查与工作树入口(@LegGasai)。
DeepSeek 官方 GitHub 仓库发布 deepseek-harness v0.2.2-alpha.3,发布说明列出:新增统一右键与键盘菜单,覆盖会话、工作区和侧边栏并支持开发者扩展(@std4453);文件预览支持常驻目录树和文件定位(@yudshj);实验性「变更请求与工作树」统一代码审查与工作树入口(@LegGasai)。
11月3日官方仓库发布该 alpha 版本,是当日可核的国内厂商工具更新。
这是 alpha 版本的官方发布说明,功能标注为实验性;作者已在10月31日单独发布过 Super-agent 研究原型,本条只针对这次版本发布,不重复讲原型。
原始来源:DeepSeek ↗
15 / 开发工具
MiniMax Code 开源 Python SDK 首个公开测试版 0.1.0b1
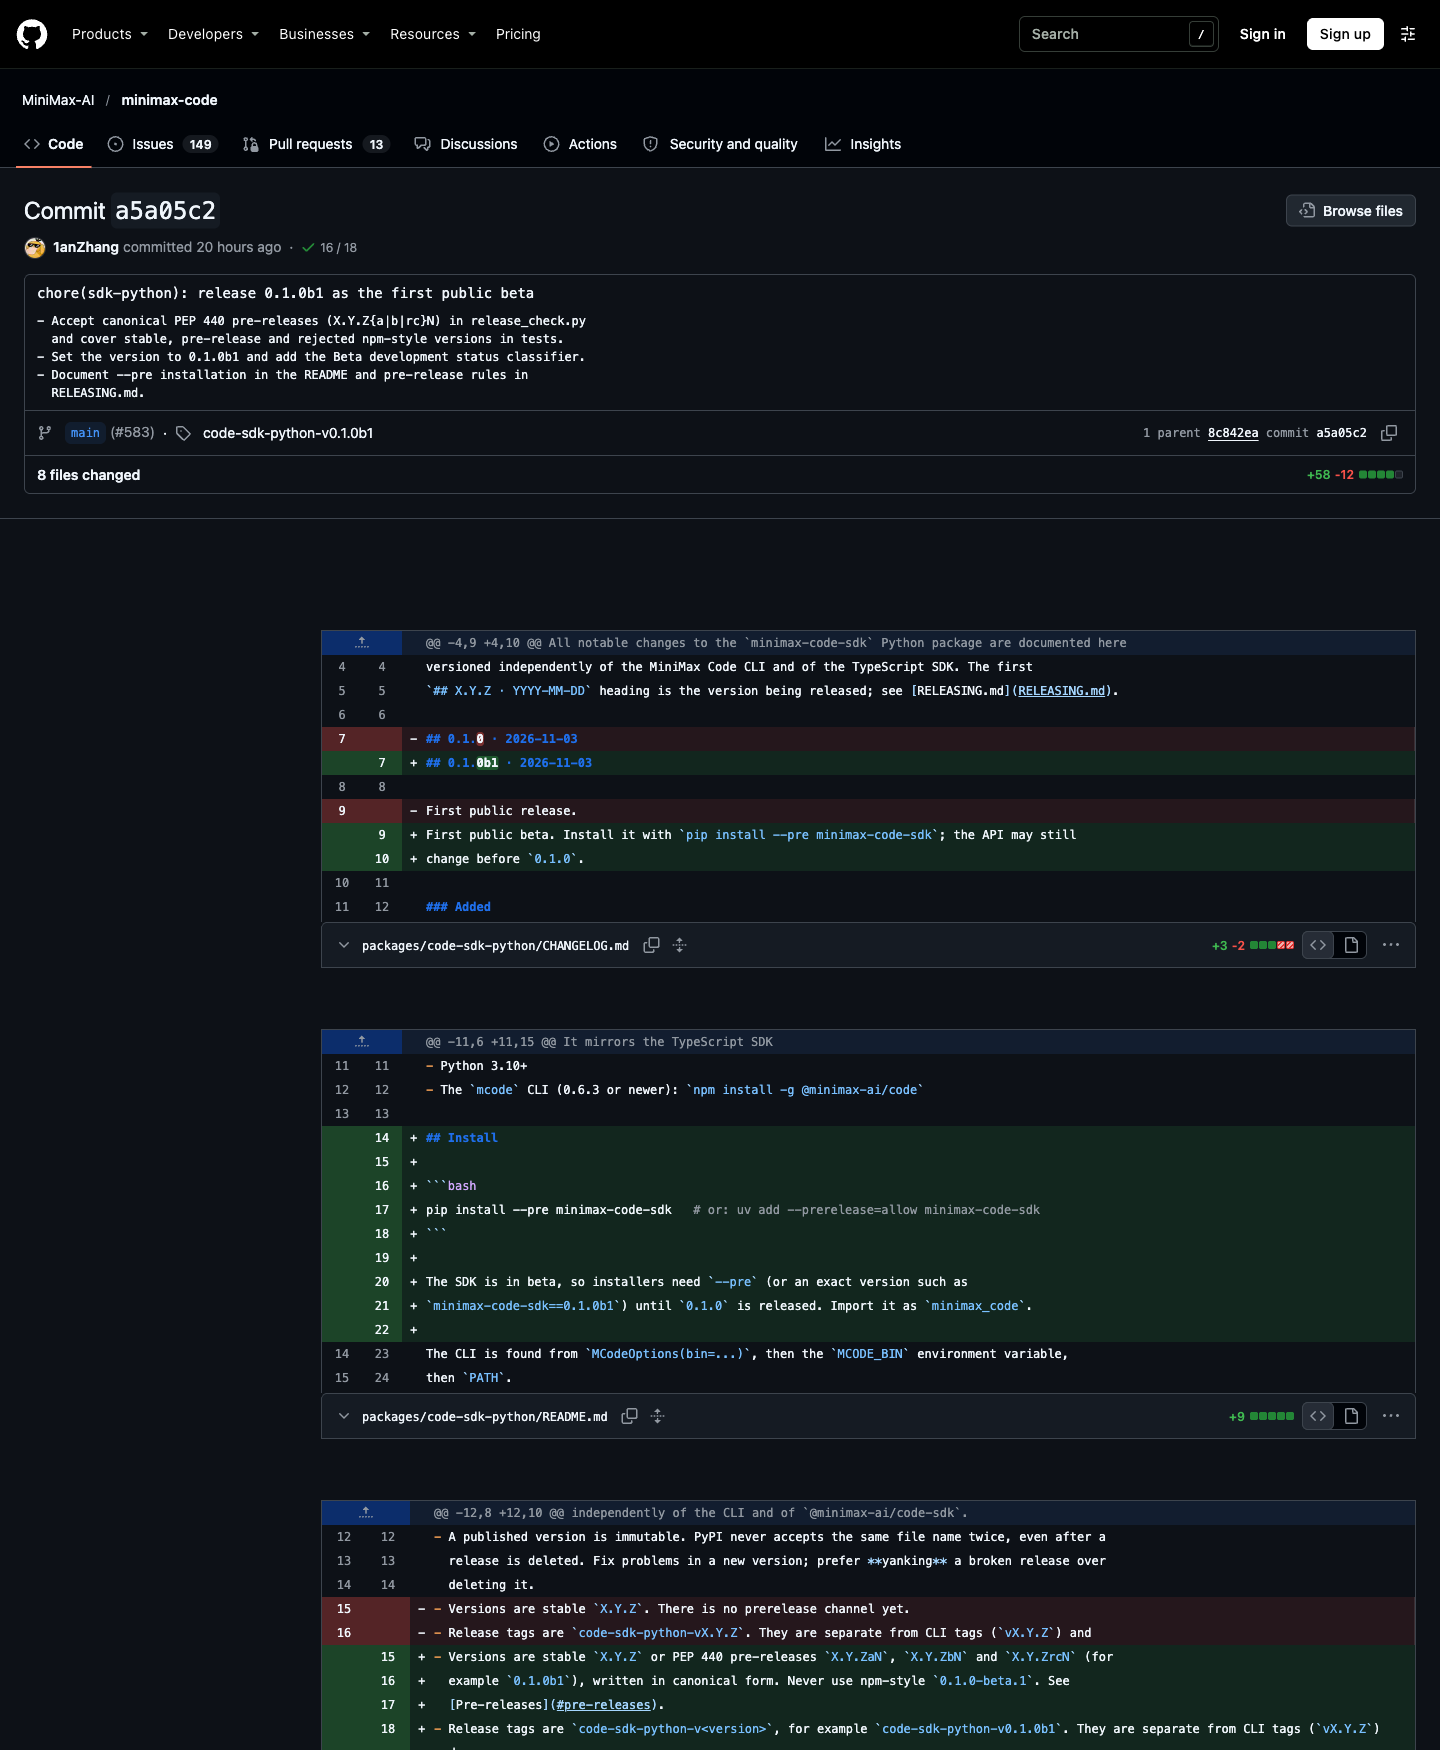
MiniMax 官方开源仓库 MiniMax-AI/minimax-code 11月3日发布 Python SDK 的首个公开测试版 0.1.0b1(发布标签 code-sdk-python-v0.1.0b1)。官方提交说明写明:该版本接受规范的 PEP 440 预发布版本号,把版本设为 0.1.0b1 并标注 Beta 开发状态,在 README 里写明 --pre 安装方式,并补充了 RELEASING.md 的预发布规则;CHANGELOG 记为 0.1.0b1 · 2026-11-03,注明这是首个公开 beta,API 在 0.1.0 之前仍可能变化。
MiniMax 官方开源仓库 MiniMax-AI/minimax-code 11月3日发布 Python SDK 的首个公开测试版 0.1.0b1(发布标签 code-sdk-python-v0.1.0b1)。官方提交说明写明:该版本接受规范的 PEP 440 预发布版本号,把版本设为 0.1.0b1 并标注 Beta 开发状态,在 README 里写明 --pre 安装方式,并补充了 RELEASING.md 的预发布规则;CHANGELOG 记为 0.1.0b1 · 2026-11-03,注明这是首个公开 beta,API 在 0.1.0 之前仍可能变化。
11月3日官方仓库发布该测试版,是当日可核的国内厂商开源工具更新。
这是 beta 阶段,官方明确写明 API 在 0.1.0 之前仍可能变化;本卡按"当前可安装的官方公开测试版"呈现,不写成稳定版。
原始来源:MiniMax(稀宇科技) ↗
16 / 评测
月之暗面发布 PerceptionBench: 把"看错"拆成10项原子能力
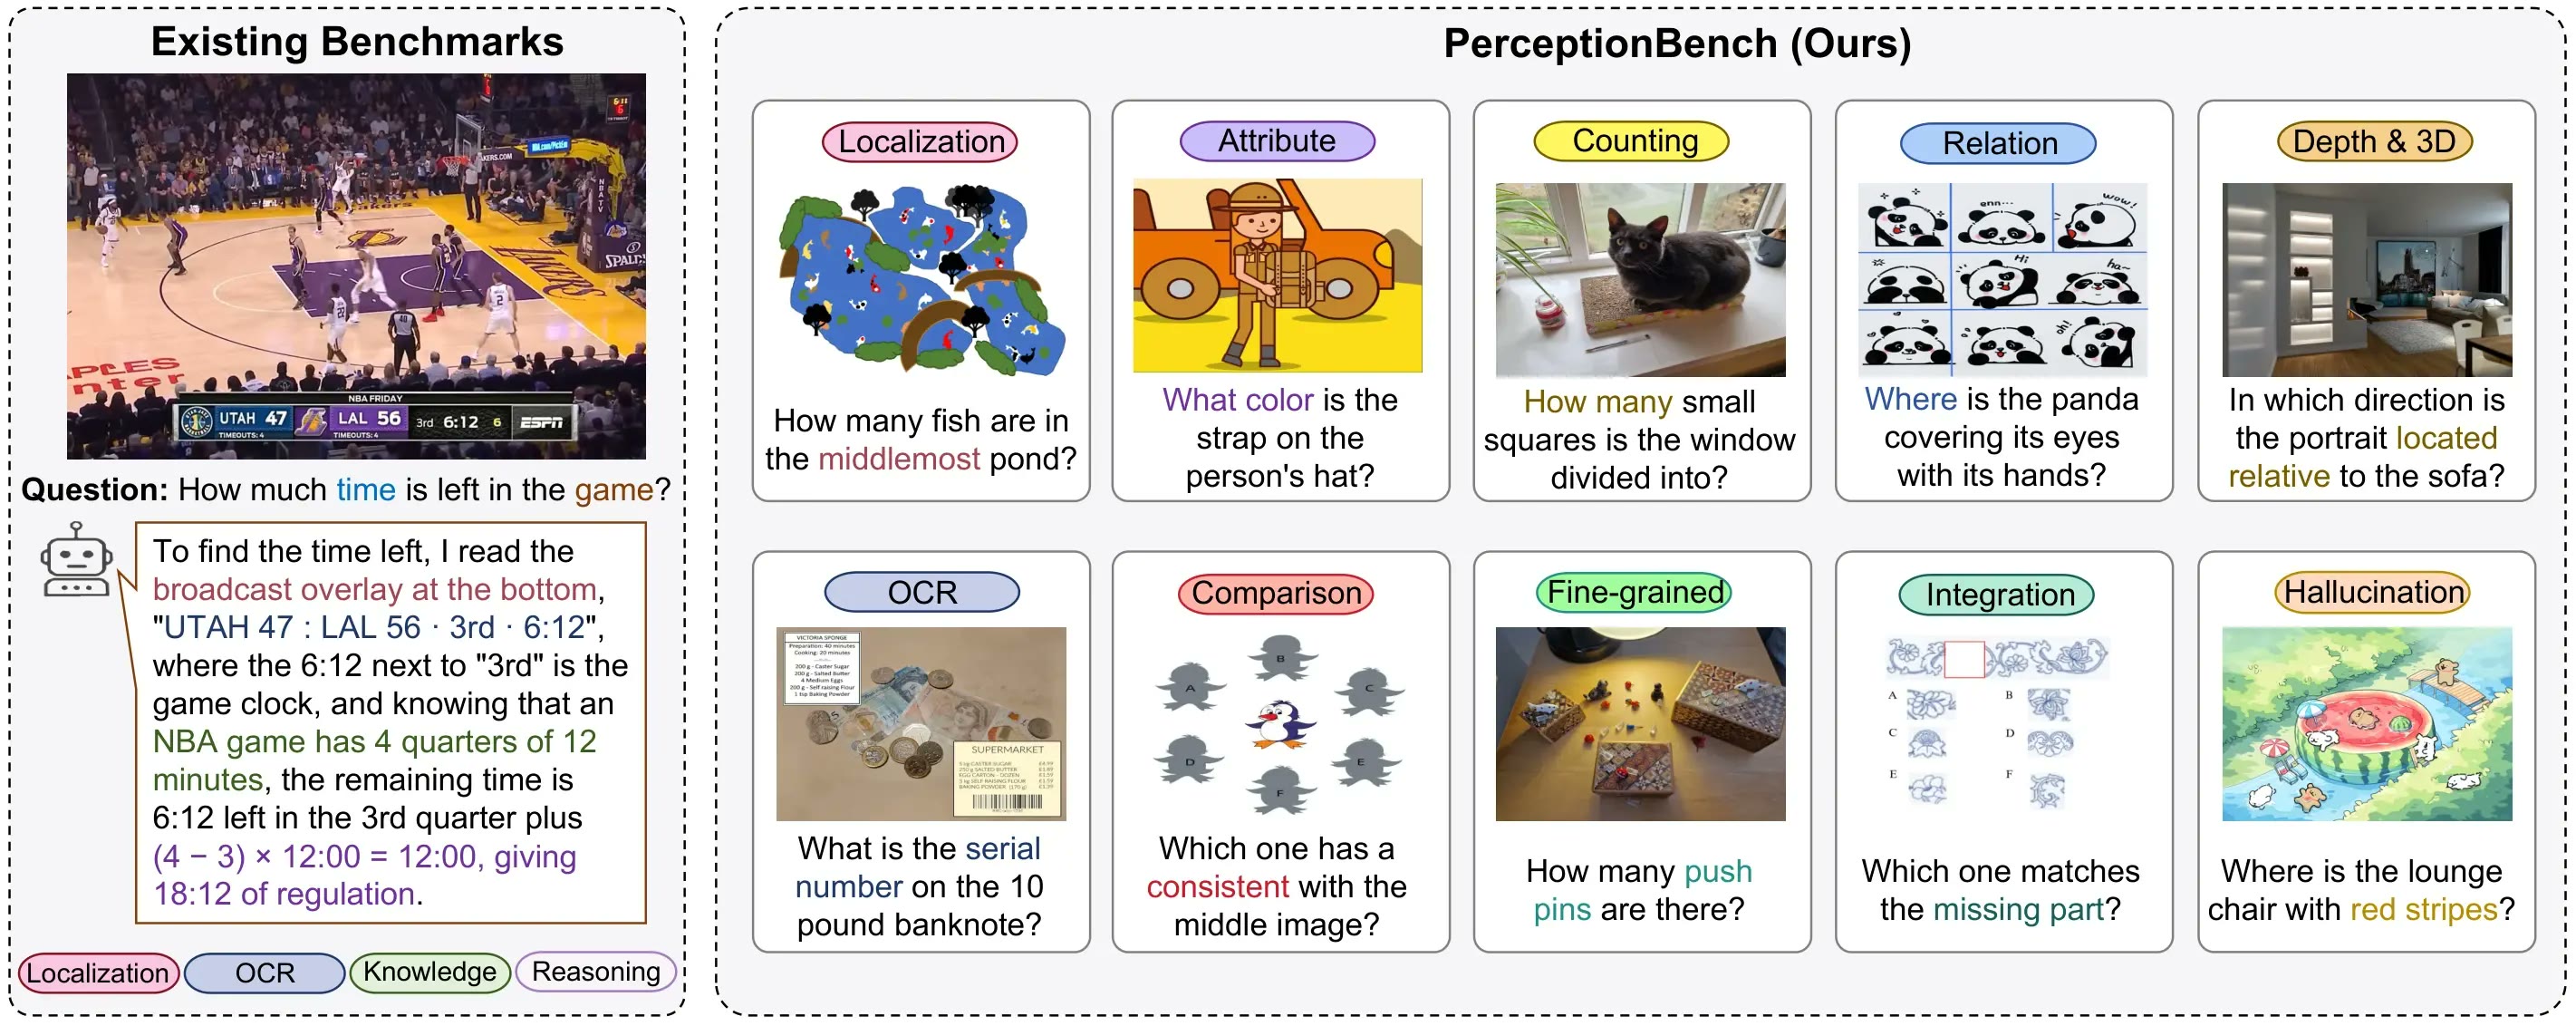
月之暗面 Kimi 官方研究博客发布 PerceptionBench,一个隔离视觉感知的基准:官方称从 42 个基准的前沿模型失败案例中归纳出 10 项原子感知能力,构建 3,000 道经验证的问题,每题只考单一能力、只需观察即可作答;发布集从自建的 17,000+ 道经验证问题中取样,其中 60% 由归因的模型失败分解而来、40% 为新撰写。
月之暗面 Kimi 官方研究博客发布 PerceptionBench,一个隔离视觉感知的基准:官方称从 42 个基准的前沿模型失败案例中归纳出 10 项原子感知能力,构建 3,000 道经验证的问题,每题只考单一能力、只需观察即可作答;发布集从自建的 17,000+ 道经验证问题中取样,其中 60% 由归因的模型失败分解而来、40% 为新撰写。
官方研究博客首次公开该基准;官方结论为:在十六个前沿多模态模型上,没有模型达到 60% 准确率,与感知相关的幻觉平均是最弱能力,总分接近的模型在实际感知上可能差异很大。官方同时公开数据集与代码入口。
这是 Kimi 自家基准与官方结论,覆盖的是被测的十六个模型与所设情境;基准题库来源包含自建部分,官方未做外部独立复现。本卡未从官方页面取得明确的发布日期标注,因此按"官方当前公开的研究基准"呈现,不写成 11 月 3 日当天发布。
原始来源:月之暗面 Kimi ↗
本期采用AI辅助编辑、AI配音与数字人呈现,原始图像与演示的出处逐条列明。
把关注,变成持续的探索。
回看其他期次,或在你习惯的平台继续关注。